こんにちは。データサイエンティストの白井です。
今日は、「PPTXやPDFをLLMに読ませるとき、入力をどう刻むと内容理解の精度が変わるのか」を実測した話を紹介します。
1枚ずつ渡すのか、数枚まとめるのか、PDFで丸ごと渡すのか。この違いだけで、精度・処理時間・コストがどう動くかを揃えた条件で比較しました。
先に本記事のポイントを書いておきます。
資料全体を統合した最終的なまとめは、どの刻み方でもほとんど変わりませんでした。
差が出たのは1ページごとの内容理解の細部でした。注記や例外条件を拾えるか、グラフの軸や目盛りを正しく読めるか、併記された数値の帰属先を取り違えないか。この記事は、その細部の話です。
はじめに
私は日々の業務で様々なパワーポイントの資料(PPTX)を目にします。
LLMを業務に活用する場合、LLMにPPTXの内容を理解してもらうことが必須です。
そして、そのコンテキストの上で、LLMと一緒に作業を進めることになります。
社内の提案書や行政資料には、1枚の中にグラフ・注記・用語の定義・分析コメントがまとめて載っているスライドがよくあります。
今回の検証で使った資料の1枚がこれです。
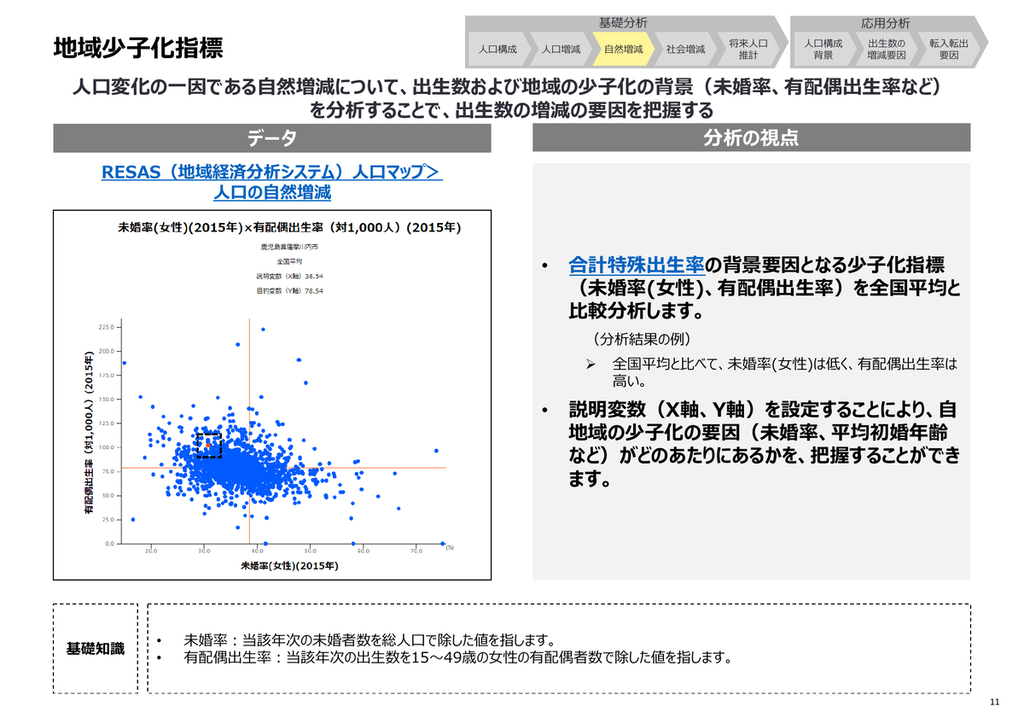
※出典:RESAS Portal - 地域課題分析ナビゲーション テーマ① 地域の人口減少対策 -(画像化して掲載)
左に散布図、右に分析の視点、下に用語の説明。
そして散布図の上には「鹿児島県薩摩川内市」「全国平均」「説明変数(X軸)38.54」「目的変数(Y軸)78.54」が縦に並んでいます。
この38.54と78.54がどちらに係る値なのか(当該市の値なのか、全国平均の値なのか)は、行間を読まないと分かりません。
実はこの箇所、後述するゴールドデータを人手で作ったときに私自身も一度間違えました。
担当者が分析手順をそのままたどれるように、1枚で「使うデータ」「分析の視点」「用語の定義」まで完結させる構成なのだろうと推測しています。人が手順書として読むには親切ですが、LLMに渡す側から見ると、1枚あたりに読み取るべき情報が多い資料ということになります。
こういう資料をLLMに渡すとき、地味に悩むのがPPTXの渡し方です。
PPTXが標準オブジェクトだけで作られていればLLMは正確に読めますが、画像貼り付けが使われている場合はvision機能が必要になります。私の周りの大抵のPPTXには画像貼り付けが使われているため、私はいつも全体をPNGにして渡していました。
しかし、ふと、この渡し方で十分だろうか?と疑問が湧き、以下3方式を検証してみようと思いました。
- 全部まとめてPDFで1回投げるのか
- 1ページずつ投げるのか
- 数ページずつブロックで投げるのか
「1枚ずつが丁寧そうだが、リクエスト数が増えて時間もコストも膨らむ」というのは感覚的に分かります。
では、実際にどれだけ細かく読み取れるようになって、どれだけ高くつくのか。
同じ資料・同じプロンプト・同じモデルで3方式を各3試行ずつ回して、その数字を出しました。
| 方式 | リクエスト数 | 1枚あたり facts件数 |
処理時間 | コスト |
|---|---|---|---|---|
| ① PDF一括 | 2 | 2.14 | 195秒 | $0.29 |
| ② 3枚ずつ | 9 | 4.33 | 573秒 | $0.74 |
| ③ 1枚ずつ | 21 | 5.98 | 816秒 | $1.00 |
1枚ずつは、1スライドから読み取る事実がPDF一括の約2.8倍。ただし時間は約4倍、コストは約3.5倍です。
そして本当の論点は、この「約2.8倍」が中身を伴った差なのかどうかです。件数が多いだけなら意味がありません。記事の後半では、増えた分に何が入っていたかを実際の出力で見ていきます。
検証の設計
対象資料と出典
使ったのは、RESAS Portalで公開されている「地域課題分析ナビゲーション テーマ① 地域の人口減少対策」というPPTXです。
自治体が人口減少の要因を分析する手順を、RESASの実際のグラフを使って解説する資料で、鹿児島県薩摩川内市を例にしています。
全27枚のうち、分析パートであるスライド5〜23の19枚を入力対象にしました。
なお、本記事内でのスライドの利用にあたっては、RESAS Portalのサイトポリシー(政府標準利用規約準拠)を確認したうえで、記事化の可否を問い合わせ窓口にメールで確認し、許諾をいただいています。
出典表記と加工の明示、免責事項は記事末尾にまとめました。
比較する3方式
比較したのは、入力の刻み方だけが違う3方式です。
モデルは全方式で Claude Sonnet 5を使いました。
| ① PDF一括 | ② 3枚ずつ | ③ 1枚ずつ | |
|---|---|---|---|
| 入力単位 | 19枚をラスタライズしたPDF 1本 | PNG 3枚ずつ(7ブロック) | PNG 1枚ずつ(19枚) |
| 解析リクエスト | 1回 | 7回 | 19回 |
| 最終統合 | 1回 | 1回 | 1回 |
どの方式も処理は2段階です。
- スライド解析:渡された画像の主メッセージ・重要な数値・注記・読み取れない箇所をJSONで出させる
- 最終統合:1の結果を全部集めて、資料全体の人口減少要因・優先課題・追加調査事項を整理させる
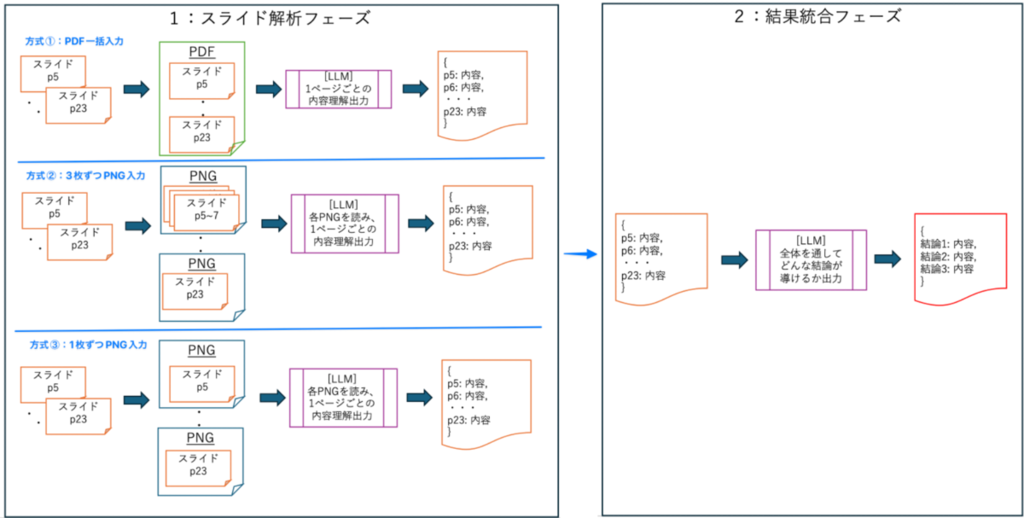
冒頭に書いたとおり、2の最終統合の出来は3方式でほとんど変わりませんでした。以降で見ていくのは1のスライド解析についてのみです(統合ステップも時間とコストは消費するので、計測には含めています)。
ポイントは、利用するプロンプトを3方式で完全に同一にしていることです。
「PDFで渡すときはスライド番号を意識してね」といった補助を足すと、比較しているものが「入力単位の違い」から「プロンプトの違い」に変わってしまうので、あえて共通のまま使いました。
スライド番号のヒントも与えていません。元資料の右下にページ番号が印字されているので、PDF一括でもPNG単体でも、画像から得られる情報量は同じという状態にしてあります。
統制した条件
「入力の刻み方」以外の差は、できるだけ合わせるようにしています。
- 同じPNG画像を使う:3方式すべて同一のレンダリング結果。PDFも、そのPNGを結合してラスタライズしたもの
- 同じプロンプト・同じ出力スキーマ:解析・統合ともに共通。JSON Schema違反時は1回だけ修復リトライ、という条件も統一
- Prompt Cachingは無効:キャッシュが効くと「刻み方によるコスト差」が見えなくなるため
- Batch APIは使わない・並列実行しない:処理時間を素直に比較するため、逐次実行
- temperature等は指定しない:モデルのデフォルト
- 各方式3試行:LLMの出力はブレるので、1回では判断しない
- 実行順はランダム化:時間帯によるAPIの混み具合が特定方式に偏らないように
最大出力トークンも揃えていますが、ここは1点だけ例外があります。
PDF一括方式は1リクエストで19枚分の解析結果を出す必要があるため、通常の6,000では確実に途中で切れます。
そのためPDF一括の解析のみ32,000を別枠で設定しました。
この統一した条件で、以下の内容をJSONフォーマットとして出力させました。
- main_message: スライドのメインメッセージ
- facts: 読み取った事実
- important_numbers: 重要指標
- conditions_and_notes: 条件や備考
- unclear_points: 不明点
利用したプロンプト(クリックで展開)
system_prompt

# 役割と目的

あなたは、日本語の行政資料(RESAS Portal「地域課題分析ナビゲーション テーマ① 地域の人口減少対策」)の内容理解を支援するアシスタントです。

この資料は、特定自治体の政策を決定するための完成済み提言書ではなく、RESAS等を用いた地域課題分析の進め方・分析例を示す教材です。あなたの役割は、資料の内容を正確に把握し、人口減少への対応として優先的に検討すべき課題とネクストアクションの叩き台を整理することです。**政策を決定すること自体は行いません。**

# 厳守事項

1. **資料に書かれていない事実を補完しない。** 資料から読み取れないことは、推測せず「不確実」「読み取れない」として明示する。
2. **数値・期間・対象地域・年齢区分を正確に区別する。** 自然増減(出生・死亡)と社会増減(転入・転出)を混同しない。
3. **すべての主張に根拠スライド番号を付与する。** 根拠のない主張は出力しない。
4. **出力は「政策決定」ではない。**(後略:政策を断定的に推奨しない)
5. **人口移動や出生に関する分析を、特定の年代・性別・個人の責任として表現しない。** 構造的要因として扱う。
6. **出力は指定されたJSON Schemaに厳密に従う。**

# 不確実性の扱い

- 数値や文言が読み取れない場合は、無理に推測せず`unclear_points`等の該当フィールドへ記録する。
- 資料内の記載が矛盾する場合は、矛盾として明示し、どちらか一方を勝手に採用しない。
- 資料だけでは判断できない事項は、`limitations`や`cannot_be_decided_from_material`に明示する。

user prompt

# スライド/ブロック解析

入力として渡されたスライド(画像、または画像とテキストの組み合わせ)を解析してください。

## 手順

1. 入力された各スライドについて、主メッセージ・重要な数値・条件や注記・読み取れない箇所を整理する。
2. 複数スライドが同時に入力された場合は、スライド間で関連する内容があれば`cross_slide_findings`に記録する。
3. 資料全体の主張につながりそうな課題の候補があれば`candidate_issues`に記録する(この時点では確定させない)。
4. 疑問点・追加確認したい点は`open_questions`に記録する。
5. **同一スライドについてスライド全体画像に加えて部分拡大画像(crop)が入力される場合**、入力順は「スライド全体」→「左上」→「右上」→「左下」→「右下」(相互に10〜15%重なる)である。cropは細部(小さな数値・注記等)の確認に使い、全体像の把握はスライド全体画像を優先する。
6. **画像に加えて、同一スライドのPowerPointから抽出したテキストが入力される場合**、画像から読み取れる内容とテキストの内容を突き合わせ、食い違いがあれば推測で解決せず`conditions_and_notes`にその旨(どちらの内容がどう異なるか)を記録する。

## 出力形式

以下のJSON Schemaに厳密に従うJSONのみを出力してください。前置き・後書き・Markdownのコードフェンスは不要です。

{
  "processed_slides": [5, 6, 7],
  "slide_findings": [
    {
      "slide_number": 5,
      "main_message": "",
      "facts": [
        { "statement": "", "evidence": "", "confidence": "high|medium|low" }
      ],
      "important_numbers": [],
      "conditions_and_notes": [],
      "unclear_points": []
    }
  ],
  "cross_slide_findings": [],
  "candidate_issues": [],
  "open_questions": []
}


important_numbers: 資料中の重要な数値を、単位・対象期間・対象地域が分かる形の文字列で記録する(例: "2065年に老年人口割合が約4割へ上昇")。
conditions_and_notes: グラフの前提条件、注記、例外条件。
unclear_points: 読み取れない・判断できない箇所。推測しない。
cross_slide_findings・candidate_issues・open_questionsの各要素は、オブジェクトではなく1つの文字列にしてください。根拠となるスライド番号を示したい場合は、文字列の中に含めてください。
読み取るべき内容の整理
出力の良し悪しを自分で判断できるように、スライド5〜23の19枚すべてについて、読み取るべき内容を人手で整理しました(以下、ゴールドデータと呼びます)。
各スライドについて、以下をJSONで記述しています。
main_message:そのスライドの主メッセージkey_numbers:重要な数値・定義・対象期間graph_trends:グラフの増減・比較関係notes_and_exceptions:注記・前提条件・例外easily_misread_points:読み違えやすい点
例えば、以下のスライド22は、
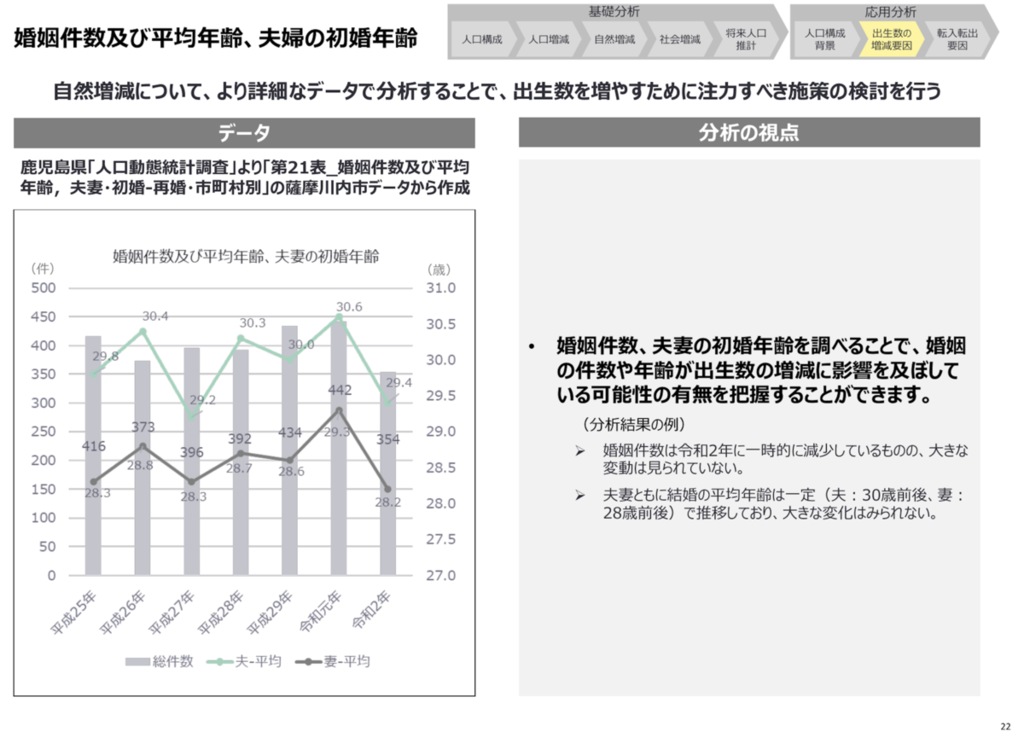
ゴールドデータとして以下のjsonを作成しています。
    {
      "slide_number": 22,
      "main_message": "婚姻件数は令和2年に一時的に減少しているが大きな変動はなく、夫婦の初婚平均年齢も夫30歳前後・妻28歳前後で安定して推移している。",
      "key_numbers": [
        "婚姻件数: 平成25年416件〜令和2年354件(令和元年442件がピーク)",
        "夫の初婚平均年齢29.2〜30.6歳(最小:平成27年29.2歳、最大:令和元年30.6歳)",
        "妻の初婚平均年齢28.2〜29.3歳(最小:令和2年28.2歳、最大:令和元年29.3歳)"
      ],
      "graph_trends": [
        "婚姻件数は416→373→396→392→434→442→354件と増減を繰り返しており単調増加ではない(平成26年・平成28年に一時的な減少)。令和元年442件がピークで、令和2年に354件へ減少",
        "夫・妻の平均初婚年齢はともに横ばい(変動幅は夫1.4歳・妻1.1歳の範囲内)"
      ],
      "notes_and_exceptions": ["出典は鹿児島県「人口動態統計調査」"],
      "easily_misread_points": [
        "左軸(婚姻件数)と右軸(平均年齢)のスケールが異なる二軸グラフのため、棒グラフと折れ線グラフの変動幅を単純比較すると誤解を招く",
        "夫-平均と妻-平均の2本の折れ線のデータラベルが近接しており、夫の値(令和2年29.4歳)を妻の値と取り違えやすい(本ゴールドデータの初版が実際にこの誤りを犯した)",
        "分析の視点欄に「婚姻件数は令和2年に一時的に減少しているものの、大きな変動は見られていない」とあるため、実データが増減を繰り返している事実を「単調増加後の減少」と単純化しやすい"
      ]
    },
このゴールドはまずLLMに作成させ、その後筆者が結果をレビューし、記載内容が正しいかを確認しました。
特に効いたのはeasily_misread_pointsです。二軸グラフ、単位が%の軸、近接したデータラベル。「ここを外したら読めていないことになる」という点を先に洗い出しておくと、3方式の出力を並べたときに何を見ればよいかが決まります。
結果
3方式の総合比較
3試行の平均値です。
| 方式 | リクエスト数 | 1枚あたり facts件数 |
処理時間 | 入力 トークン |
出力 トークン |
コスト |
|---|---|---|---|---|---|---|
| ① PDF一括 | 2 | 2.14 | 195秒 | 44,896 | 19,619 | $0.29 |
| ② 3枚ずつ | 9 | 4.33 | 573秒 | 128,980 | 48,609 | $0.74 |
| ③ 1枚ずつ | 21 | 5.98 | 816秒 | 185,388 | 62,901 | $1.00 |
この結果から、以下が分かります。
- 1枚あたりに読み取る事実(facts)の件数は ③ > ② > ① の順にきれいに並んだ。刻みを細かくするほど細かく読む、という素朴な予想通りの結果
- ①のfacts件数は明確に少ない。2.14件は②の約半分、③の約1/3
- ②と③の差はほぼ比例。②→③は件数1.38倍に対し、時間1.4倍・コスト1.35倍。細かく刻んだ分だけコストを払っている
- 処理速度とコストは ① > ② > ③。①→③で時間4.2倍・コスト3.5倍
時間・コストの内訳と、比較上の注意(クリックで展開)
上表の内訳は以下です(1試行あたり、API実測値)。
| 方式 | 解析ステップ | 最終統合 |
|---|---|---|
| ① PDF一括 | 1回 133秒 / $0.197 | 1回 55秒 / $0.089 |
| ② 3枚ずつ | 7回 326秒 / $0.471 | 2回 165秒 / $0.273 |
| ③ 1枚ずつ | 19回 520秒 / $0.623 | 2回 195秒 / $0.377 |
②③の統合が2回になっているのは、検証途中で統合ステップの出力上限不足(截断)が見つかり、公平性のため全試行を上限を上げて再実行したためです。失敗した旧リクエストもログに残しているので、②③の計測値には2回分が含まれています(①は上限修正後に実行したため1回)。
統合1回分に揃えて概算すると、時間は195秒 / 409秒 / 617秒、コストは$0.29 / $0.61 / $0.81となり、①→③の倍率は時間3.3倍・コスト2.8倍になります。倍率の大小は変わりますが、順序と桁感は変わりません。
処理時間は壁時計ベースです。検証中にPCがスリープした試行があったため、API計測時間との乖離を検知して除外した頑健値を使っています。
料金は検証時点のSonnet 5の導入価格(入力$2.00 / 出力$10.00 per 1M tokens)で計算しています。
増えた分に何が入っていたか
件数の話はここまでです。ここからは、その差が中身を伴っているのかを、実際のスライドと出力内容で見ていきます。
スライド9
まずは、スライド9です。
このスライドは、赤線の総人口だけが右軸で、他の値は左軸で表現されています。
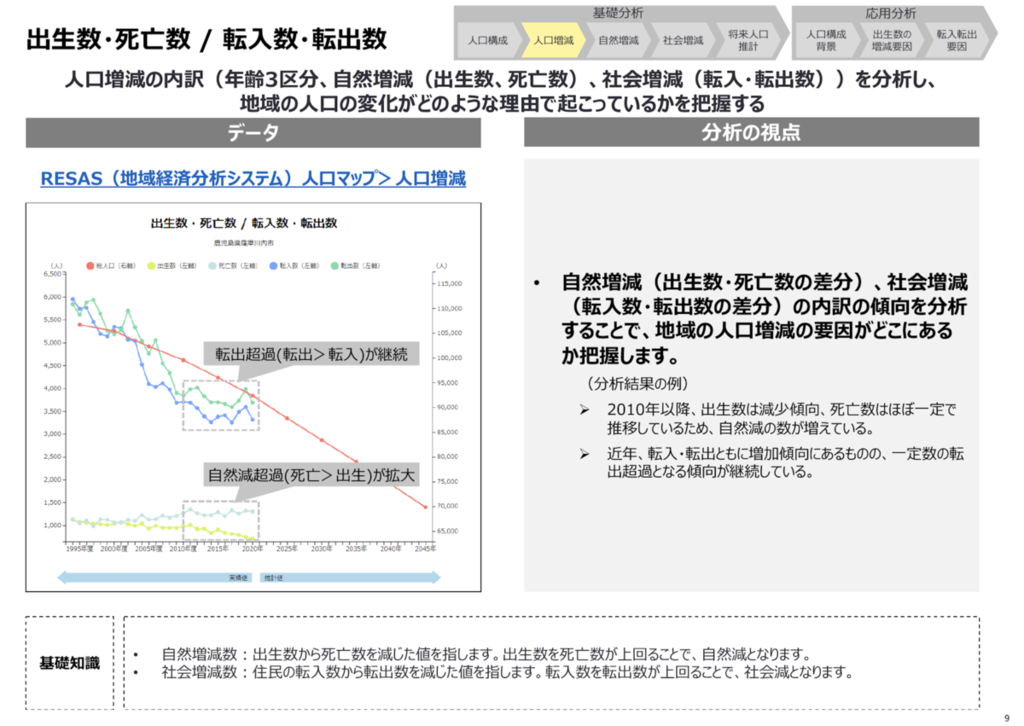
各手法でのimportant_numbers(重要指標)の結果は以下です。
①<②<③と、抽出できた重要指標の数が増えていることが分かります。
特に、①では左右の軸に関する言及はありませんが、②と③ではしっかりと言及がされています。
| 種別 | 結果 |
|---|---|
| ① PDF一括 | [総人口推計:1995年度〜2045年(実績値・推計値、薩摩川内市)] |
| ② 3枚ずつ | ["対象期間:1995年度〜2045年(実績値は〜2020年頃まで、以降は推計値)","総人口軸:右軸、目盛り約65,000〜115,000人","出生・死亡・転入・転出数:左軸、目盛り約1,000〜6,500人"] |
| ③ 1枚ずつ | ["対象期間:1995年度頃〜2045年(実績値と推計値を含む、薩摩川内市)","総人口軸(右軸):目盛65,000人〜115,000人の範囲で表示(薩摩川内市、期間中の推移)","出生数・死亡数・転入数・転出数軸(左軸):目盛500人〜6,500人の範囲で表示(薩摩川内市、期間中の推移)","2010年度以降、自然減(死亡数が出生数を上回る状態)が拡大傾向(薩摩川内市)","近年、転入・転出ともに増加傾向だが一定の転出超過が継続(薩摩川内市)"] |
スライド7
次は、スライド7です。
このスライドは、縦軸の単位が%であり、実数ではないことが注意点です。
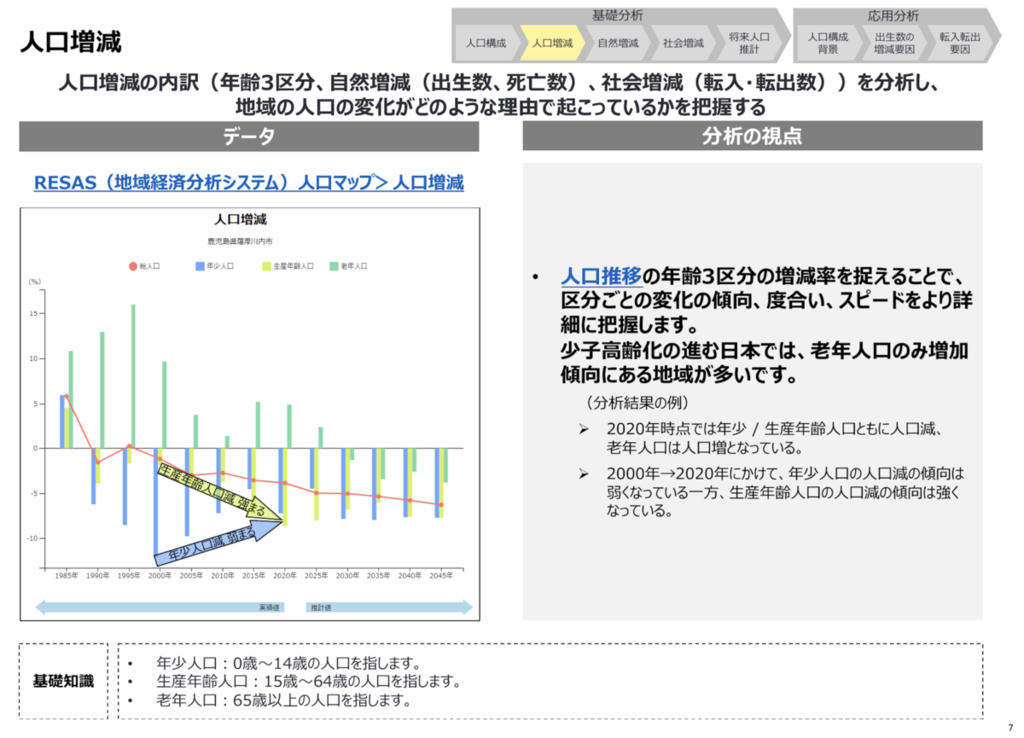
各手法でのconditions_and_notes(条件や備考)の結果は以下です。
こちらもスライド9同様に①<②<③と、抽出した備考の数が増えていることが分かります。
縦軸の単位が%であることに注意を促しているのは、③のみです。
| 種別 | 結果 |
|---|---|
| ① PDF一括 | ["年少人口=0〜14歳、生産年齢人口=15〜64歳、老年人口=65歳以上(基礎知識欄)。"] |
| ② 3枚ずつ | ["グラフは1985年〜2020年頃までが実績値、それ以降が推計値である(グラフ下部の矢印表示)。", "年少人口:0〜14歳、生産年齢人口:15〜64歳、老年人口:65歳以上と定義されている。", "本スライドは自然増減(出生・死亡)と社会増減(転入・転出)の内訳分解には踏み込んでおらず、年齢3区分の増減率のみを扱っている。"] |
| ③ 1枚ずつ | ["グラフの縦軸は増減率(%)であり、実数(人数)ではない点に留意が必要。", "2020年以前が実績値、2020年以降(2025年〜2045年)が推計値であることがグラフ下部の矢印で明示されている。", "グラフ上の具体的な数値ラベルは示されておらず、目視での概算読み取りにとどまるため、正確な増減率数値は資料からは確定できない。", "本スライドは特定自治体(薩摩川内市)を用いた「分析例」であり、教材としての位置づけであることがヘッダーのナビゲーション(基礎分析:人口構成→人口増減→自然増減→社会増減→将来人口推計、応用分析:人口構成背景→出生数の増減要因→転入転出要因)から読み取れる。"] |
これらの結果を見ると、① PDF一括は抽出内容が大雑把になりがちで、一方、②と③は詳細を読み解こうとしていることが分かります。
さらに②よりも③の方が、細かく指標や条件を抽出しようとしていることが分かります。
つまり、facts件数の差は水増しではなく、軸・単位・注記という「外すと読み違える」項目の差でした。ゴールドのeasily_misread_pointsに挙げた罠のうち、二軸グラフの識別は②から拾われ、軸の単位まで届くのは③のみ、という並びになっています。
使い分けの指針
結局のところ、どこまで細部が必要かで選べばよいという話になります。
- ① PDF一括:大雑把に、早く内容を理解したいとき
- ② 3枚ずつ:詳細に把握したいが、完全な細部までは不要なとき
- ③ 1枚ずつ:時間をかけても、詳細までしっかり把握したいとき
そのうえで、入れておいた方がいい実装上の備えを挙げておきます。
- スライド単位の中間出力を必ず持つ。PDFから直接まとめさせる構成も試しましたが、根拠として引用するスライド番号がズレました(対象外のスライド1〜4を引用する誤りが3試行中2試行で発生)。解析ステップを1段挟むだけで、根拠スライド番号の妥当性は0.886→1.000になりました
- スライド番号の欠落を機械的に検知する。まとめて渡す方式は、1リクエストの失敗がブロック全体の欠落になります
- 出力上限は実測で決める。当初は解析2,000 / 統合3,000で設定していましたが、実測では1スライドの解析ですら截断されました。最終的に解析6,000 / 統合20,000(PDF一括の解析のみ32,000)です
- クライアントのタイムアウトを確認する。PDF一括の解析は128〜136秒かかり、SDKの既定タイムアウト120秒に足りず3回連続で失敗しました。長い入力を1回で投げる方式では、まず疑うべきポイントです
- 不確実性の明示を許すプロンプトにする。「読み取れない箇所は推測せず
unclear_pointsに書く」と指示しておくと、スライド11のような罠で断定を回避してくれます
おまけ:PPTXをPNG化すると画像がズレる
最後に、LLMに渡す前段でハマった話です。
画像化の処理をLLMに書かせたら、当然のようにLibreOffice(soffice --headless --convert-to pdf → pdftoppm)を使う実装が出てきました。ところがこれ、資料のフォントが環境に無いとフォント代替が起きてレイアウトが崩れます。今回の資料はMeiryo UIなどを使っていて未埋め込みだったため、本文の行数が増え、一部スライドで下の見出し帯にテキストがはみ出して重なりました。入力画像がズレていては、比較検証にすらなりません。
回避するには、フォントを持っているアプリに描画させるのが確実です。macOSのMicrosoft PowerPoint.appはアプリ内部(Contents/Resources/DFonts/meiryo.ttc)にMeiryoを同梱しているので、ここを通せば崩れません。
- 手作業でよければ:PowerPointから直接PNGエクスポート
- 自動化するなら:PowerPointでPDFに書き出してから、
pdftoppmで1枚ずつPNG化
今回は後者を使いました。資料側でフォントを埋め込んでもらえるなら、それが最善です。
おわりに
今回は、情報量の多い日本語行政資料をClaude Sonnet 5に読ませるとき、入力の刻み方だけで読み取りの細かさ・時間・コストがどう変わるかを実測しました。
- 資料全体を統合したまとめは、どの刻み方でもほぼ同じ。差が出るのは1ページごとの内容理解の細部
- その細部の読み取り量は「1枚ずつ > 3枚ずつ > PDF一括」の順で、1枚あたり5.98件 / 4.33件 / 2.14件
- 増えた分は水増しではなく、軸・単位・注記という「外すと読み違える」項目だった
- 1枚ずつは最も細かく読むが、PDF一括に比べて時間4.2倍・コスト3.5倍
- PDF一括が落とすのは数値そのものより、注記・例外条件・軸の但し書き。しかもこれは出力上限の問題ではなく、モデルが自ら記述を圧縮する挙動
- 3枚ずつは「まとめて1回」をやめる効果の半分以上を取れる。ただしブロック欠落のリスク管理が必要
- 図の情報量そのものに起因する誤読は、刻み方を変えても消えない
個人的にいちばん意外だったのは、方式ごとに強みの質が違ったことです。
細かく刻むと数値の網羅性が上がり、まとめて渡すと資料全体の枠組みを取り違えにくくなる。「精度」という一つの数字に丸めると、この非対称性が見えなくなってしまいます。実運用では、一括入力で全体の枠組みを掴んだうえで、数値の根拠が必要なスライドだけ1枚ずつ精読させる、という組み合わせも十分にありだと思います。
もちろん限界もあります。対象は1つの資料(19スライド)だけで、各方式3試行のみ。中身の確認は筆者の目視です。資料の種類(文字中心の議事録、表中心の財務資料など)が変われば、最適な刻み方も変わるはずです。
それでも、「1ページずつか、まとめてか」を感覚ではなく数字で決めたいときに、当たりをつける材料にはなるかと思います。本記事が、誰かの参考になれば幸いです。
出典・注意事項
出典
出典:RESAS Portal - 地域課題分析ナビゲーション テーマ① 地域の人口減少対策 -(https://resas-portal.go.jp/region/)
加工内容
本記事では、上記資料のスライド5〜23を検証対象とし、PNG画像化・PDF結合・縮小を行った上でLLMへ入力しています。
掲載しているスライド画像は、検証目的での画像化・縮小を行ったものです(RESAS Portalを加工して作成)。
記事化にあたっては、サイトポリシー(政府標準利用規約準拠)を確認のうえ、問い合わせ窓口へメールで確認し、利用の許諾をいただいています。
免責・注意事項
- 本記事は筆者による技術検証の内容であり、当社での正式な推奨手法や導入事例を示すものではありません。実際の業務適用にあたっては、各組織のガイドラインに従ってください。
- 本検証はLLMの内容理解支援力を確認する技術検証であり、対象資料や特定自治体の政策を評価・決定するものではありません。
- LLMの出力は筆者による技術検証の結果であり、内閣府・RESAS Portal・資料内で言及される自治体の見解ではありません。
- 資料内に掲載された分析例を、対象地域の最新の人口動態や政策状況として扱わないでください。
- 人口移動や出生に関する分析結果を、特定の年代・性別・個人の責任として解釈しないでください。
- 料金は検証時点(2026年8月)のClaude Sonnet 5の価格に基づく実測値です。最新の価格は公式ドキュメントをご確認ください。
